Umbrales y datos ausentes en GA4: cuando el número desaparece
Umbral de datos, muestreo y fila (other) hacen que los números de GA4 desaparezcan o cambien. Aprende a distinguirlos y qué hacer, con fuentes oficiales.
Contenido
Cuando un número desaparece o cambia en GA4, casi siempre la causa es una de tres: umbral de datos (GA4 retiene filas para proteger la identidad de los usuarios), muestreo (el informe usa solo parte de los eventos) o la fila "(other)" (valores poco frecuentes agrupados). Cada una tiene una señal distinta en pantalla y una salida distinta. Saber cuál actúa evita rehacer filtros en vano y explicarle al cliente un "error" que no existe.
Tres mecanismos distintos, un síntoma parecido
Para el analista el síntoma es el mismo: el número no es el que esperaba. Pero los tres mecanismos no tienen nada más en común.
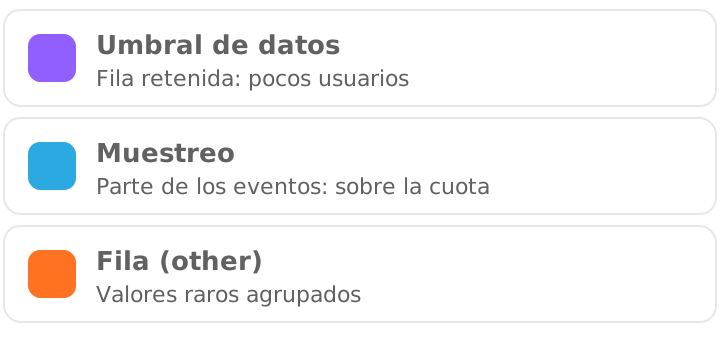
En una tabla, la diferencia está en lo que pasa con los datos:
Umbral de datos
- Qué ocurre
- Filas retenidas por pocos usuarios
- Dónde lo ves
- Aviso de umbral en las tarjetas del informe
- Salida principal
- Ampliar el intervalo de fechas
Muestreo
- Qué ocurre
- Estimación con parte de los eventos
- Dónde lo ves
- Ícono de calidad con el porcentaje usado
- Salida principal
- Reducir los eventos de la consulta o usar 360
Fila (other)
- Qué ocurre
- Valores poco frecuentes agrupados
- Dónde lo ves
- Una fila llamada "(other)"
- Salida principal
- Menos dimensiones de alta cardinalidad
| Mecanismo | Qué ocurre | Dónde lo ves | Salida principal |
|---|---|---|---|
| Umbral de datos | Filas retenidas por pocos usuarios | Aviso de umbral en las tarjetas del informe | Ampliar el intervalo de fechas |
| Muestreo | Estimación con parte de los eventos | Ícono de calidad con el porcentaje usado | Reducir los eventos de la consulta o usar 360 |
| Fila (other) | Valores poco frecuentes agrupados | Una fila llamada "(other)" | Menos dimensiones de alta cardinalidad |
Umbral de datos: GA4 retiene filas para proteger a las personas
La Ayuda de Google Analytics explica que los umbrales existen para impedir que quien ve un informe infiera la identidad de usuarios o información sensible a partir de señales como datos demográficos e intereses. Los umbrales los define el sistema y no se pueden ajustar. La página no informa un número mínimo de usuarios, así que cualquier valor citado por ahí como "el límite" no viene de la documentación oficial.
La Ayuda describe dos situaciones en que se pueden retener datos:
- Datos demográficos. Un informe, una exploración o una llamada a la API que incluya datos demográficos, o una audiencia definida por datos demográficos, puede tener datos retenidos.
- Consultas de búsqueda. Una fila de información de consultas de búsqueda puede retenerse cuando no hay suficientes usuarios totales.
Cuando se aplica el umbral, el indicador de calidad de datos muestra el mensaje de que GA4 aplicó umbrales a una o más tarjetas del informe. Ese es el primer lugar donde mirar antes de suponer que la recolección falló.
Qué reduce la probabilidad de umbral
La Ayuda dice que no puedes ajustar el umbral, pero sí reducir la probabilidad de que aparezca. La acción documentada es ampliar el intervalo de fechas: los intervalos cortos, con pocos usuarios o eventos, tienen más probabilidad de que se retengan datos, y un período mayor puede reunir suficientes usuarios.
En la práctica, esto cambia cómo armas informes para clientes pequeños. Un informe diario con edad y género cruzados con una campaña tiene más probabilidad de perder filas que el mismo informe mensual. Si la pregunta del cliente es sobre el perfil de la audiencia, responde con el mes o el trimestre, no con el día.
Por qué BigQuery muestra números diferentes
La Ayuda también advierte que GA4 no exporta a BigQuery los datos de las señales de Google, y que por eso el recuento de eventos por usuario puede diferir entre ambos. No es un defecto de tu informe: son conjuntos de datos distintos. Al comparar las dos fuentes, registra de dónde vino cada número.
Muestreo: el informe usa parte de los eventos
La Ayuda define el muestreo como el análisis de un subconjunto de datos para estimar los resultados de un conjunto mayor, lo que permite obtener datos más rápido con poco impacto en la calidad. Puede ocurrir en los informes estándar y en las exploraciones cuando el número de eventos usado en la consulta supera la cuota de la propiedad.
La misma página trae los números de la cuota:
- Propiedades estándar: 10 millones de eventos por consulta.
- Google Analytics 360: hasta 1.000 millones de eventos, con un valor inicial predeterminado de 100 millones de eventos por consulta.
Cuando los resultados están muestreados, el ícono de calidad de datos muestra el porcentaje de datos usado. Cuanto mayor la muestra, en general más precisos los resultados. La página también señala que filtrar un conjunto grande de datos por país puede causar muestreo.
Los datos sin muestreo están disponibles solo en Google Analytics 360, según la Ayuda de las exploraciones. En una propiedad estándar, la salida es disminuir el volumen de eventos de la consulta, por ejemplo con un período más corto.
Los recuentos únicos también son estimaciones
Incluso sin muestreo, la Ayuda dice que los informes usan el algoritmo HyperLogLog++ para estimar recuentos distintos, como usuarios y sesiones. La diferencia suele ser inferior al 1%, pero puede ser mayor, sobre todo al combinar varias métricas que usan ese algoritmo.
Un ejemplo hipotético para dar la escala: en un informe con 10.000 usuarios, el 1% equivale a 100 usuarios. Una diferencia de ese orden entre dos informes de la misma propiedad no indica un error de recolección. Diferencias mucho mayores merecen investigación.
La fila "(other)": cuando la tabla tiene demasiadas filas
La Ayuda explica que la fila "(other)" aparece cuando una tabla pasa del límite de filas: GA4 muestra los valores más comunes de la dimensión y condensa los menos comunes en la fila "(other)".
El número de filas crece con la cardinalidad, que es la cantidad de valores que puede tener una dimensión. En tablas con varias dimensiones, el total de filas puede llegar al producto de los valores de cada una. El ejemplo de la propia Ayuda: dispositivo con 3 valores combinado con edad con 6 valores puede generar hasta 18 filas.
Un ejemplo hipotético con la misma cuenta: agrega la ciudad, con 40 valores, y la tabla puede llegar a 3 × 6 × 40 = 720 filas. Cuantas más dimensiones cruzas, más fácil es caer en "(other)".
La página no fija un límite exacto de filas. Orienta que una dimensión con más de 500 valores se considere de alta cardinalidad, y deja claro que ese número es una orientación, no un límite. También dice que los informes con dimensiones secundarias, filtros o comparaciones tienen más probabilidad de tener la fila "(other)", y que las propiedades 360 tienen límites mayores.
Cómo evitarla
Las recomendaciones oficiales son:
- Usa las dimensiones existentes antes de crear dimensiones personalizadas.
- No uses dimensiones de alta cardinalidad sin necesidad.
- No crees una dimensión personalizada para tener un identificador distinto por usuario. Usa User-ID.
- Usa informes estándar siempre que sea posible, porque tienen tablas agregadas. Un informe estándar con una dimensión rara vez se ve afectado.
- Para datos de alta cardinalidad, envíalos mediante parámetros de evento y propiedades de usuario, en lugar de registrar dimensiones personalizadas. Aún puedes usarlos en BigQuery y en audiencias.
Cómo te avisa la API de lo que pasó
Si extraes datos de GA4 con la API de datos, la respuesta trae metadatos que indican cuál de los tres casos ocurrió. En la referencia de ResponseMetaData:
subjectToThresholding: si es verdadero, el informe está sujeto a umbrales y solo devuelve datos que cumplen los límites mínimos de agregación.samplingMetadatas: si el informe fue muestreado, describe el porcentaje de eventos usado.dataLossFromOtherRow: si es verdadero, algunos grupos de combinaciones de dimensiones se reunieron en la fila "(other)".
Quien arma informes automáticos debe leer esos campos y mostrar el aviso junto al número. Un panel que muestra la tabla sin avisar que vino con umbral o "(other)" transmite una precisión que el dato no tiene.
Cómo aplicar
- 1.Antes de investigar el tracking, mira el indicador de calidad de datos del informe. Dice si hay umbral o muestreo.
- 2.Si hay umbral, amplía el intervalo de fechas y reduce el cruce con datos demográficos. Si el cliente necesita granularidad diaria, avísale que algunas filas pueden no aparecer.
- 3.Si hay muestreo, acorta el período o reduce el volumen de eventos de la consulta, y anota el porcentaje que muestra el ícono al reportar el número.
- 4.Si aparece "(other)", quita dimensiones de alta cardinalidad de la tabla y prefiere los informes estándar.
- 5.En integraciones por API, lee
subjectToThresholding,samplingMetadatasydataLossFromOtherRowen cada respuesta y muestra el aviso junto al número. - 6.Al comparar con BigQuery, recuerda que los datos de las señales de Google no se exportan y que los recuentos pueden diferir.
- 7.Registra en el diccionario de métricas del cliente que los números de GA4 pueden tener umbral, muestra o "(other)", y qué informes usar para el número oficial.
Fuentes
Consultadas el 23 de octubre de 2026.
Este artículo también está disponible en Markdown, para agentes y LLMs: ver versión .md